今天内核圈两件事,一件在传输层:QUIC 要以 IPPROTO_QUIC 的身份住进内核 ——握手仍归用户态,握手之后的整条传输链路全在内核里跑。另一件在内存:匿名大页换出时不再被拆成 512 个 4K swap entry ,一条 PMD swap entry 让大页扛过整轮 swap 往返。
🎬 今日导读 / section 头条 QUIC 以 IPPROTO_QUIC 住进内核:握手归用户态,传输全在内核(v15·15 帖)
头条 PMD swap entry:匿名大页换出不再拆成 512 个 4K 条目(v7·29 帖)
net 7.1 加的一道校验,把 IFLA_INET_CONF 的旧用户态读法打挂了
mm VM_SPECIAL 退场,VMA flag 改成「说行为」的谓词(v2·40 帖)
mm collapse 57 帖 RFC 迎来实质评审:并发与 rmap 锁序是焦点
media ipu6 为「一个源多条流」做的 21 帖铺垫
media camss 第一次支持 CSI-2 桥后面挂多颗摄像头(8 帖)
DRM 联发科一次补齐 DSC、WDMA 写回与 MT8189/96 DSI(v7·13 帖)
PCI P2PDMA 按 TLP 类别决定点对点路由(v6·18 帖)
Rust 一个用 LLM 找 bug 的工具,在 safe trait 里挖出不健全
block iocost 成本模型终于可插拔,先拿出 112 倍定价偏差的证据(RFC v3·5 帖)
💡 今日头条 / section 内核要内置 QUIC 了:socket 家族多一个 IPPROTO_QUIC 〔09-14 21:52 北京〕· [PATCH net-next v15 00/15] net: introduce QUIC infrastructure and core subcomponents
现状 QUIC(RFC 9000)是跑在 UDP 之上的加密多路复用传输,也是 HTTP/3 的底座。它一直活在用户态——quiche、ngtcp2、msquic 这些库各自实现,内核只负责把 UDP 报文递上去,剩下的全是用户态的事。
痛点 用户态实现有两个绕不开的账。一是边界成本:每次收发都要过一趟 syscall,连接 ID 管理、流调度、拥塞控制、定时器、ACK 处理全在用户态做。二是内核自己人用不上:NFS、SMB(ksmbd)想跑在 QUIC 上,要么在用户态绕一大圈,要么在内核里再塞一份协议栈。此外,同一个 QUIC 端口上的多条连接怎么分给不同进程,用户态方案只能靠各自绑定端口。
方案 v15 把 QUIC 做成 socket 家族:定义 IPPROTO_QUIC / SOL_QUIC,像 MPTCP 那样在内核里建 socket,跑在 UDP 隧道之上。分工是整套设计的核心——握手交给用户态 (只处理、生成 TLS Handshake 消息,用 GnuTLS 一类的库),内核与用户态之间用 sendmsg()/recvmsg() 加控制消息(cmsg)交换握手信息;握手之外的一切都在内核 :包解析与构造、连接 ID 管理、流管理、路径管理、拥塞控制、密钥派生与加解密、定时器、包号空间。内核消费者走已有的 net/handshake netlink 发起握手请求,由 tlshd 一类的用户态服务接手;还支持按 ALPN 把连接分发给不同的用户态进程。
为什么 没有走 ULP(上层协议)路线,而是自成 socket 家族——ULP 只能挂在 TCP 上,QUIC 跑的是 UDP。握手之所以留在用户态,是因为 TLS 的密码学实现和证书验证本就是用户态的成熟地盘(内核不做 X.509 验证),内核只接管握手完成之后的传输。把控制消息全部收进内核,正是这套设计最主要的收益来源:省掉 syscall。
效益 内核子系统第一次能用标准的内核传输接口跑 QUIC,改动最小;用户态则拿到一套 POSIX 风格的 socket API(listen/accept/connect/sendmsg/recvmsg/close 与 getsockopt/setsockopt)。系列里留了 sendfile() 这类零拷贝的口子,也为将来把加解密卸给硬件留了位置。
下一步 v15 已覆盖 RFC 9000/9001/9002/9221/9287/9368/9369。这 15 帖是「基础设施与核心子组件」,真正值得盯的是谁第一个作为消费者接上去——SMB 还是 NFS。
一句话点评 内核态 QUIC 是一场拉锯多年的争议,v15 的意义不在新增功能,而在 socket 家族与「握手归用户态、传输归内核」这套分工终于定型。
🔗 原文
THP 换出不再碎成 512 个 4K 条目:一条 PMD swap entry 扛过整轮 swap 〔09-14 19:43 北京〕· [PATCH v7 00/29] mm: PMD-level swap entries for anonymous THPs
现状 匿名 THP 被换出时,内核先把 PMD 映射拆成 HPAGE_PMD_NR(512)个 4K 页,逐页写进 swap,页表里留下 512 个 PTE 级 swap entry(走 TTU_SPLIT_HUGE_PMD 路径)。
痛点 拆一次就丢一次。512 个 swap entry 要单独分配一个 PTE 页表页来记住它们;而换回时这条路径早已不记得「它们原本是一整块」,想再变大页只能等 khugepaged 事后来折叠——中间这段时间,负载就跑在 4K 页上,TLB 和缺页两头的账都回来了。
方案 引入 PMD 级 swap entry:一个紧凑的页表编码,代表 HPAGE_PMD_NR 个连续 swap 槽位。换出时 PMD 映射原地转成一条 PMD swap entry,不再拆;换入时 do_huge_pmd_swap_page() 直接把 PMD 映射装回去,不必等 khugepaged。29 帖的顺序是刻意排的:9~27 帖先把所有消费者改造到能处理 PMD swap entry(缺页、swapoff、MADV_WILLNEED、UFFDIO_MOVE、mincore…),第 28 帖生产者才最后安装。
为什么 关键取舍是不承诺 swap cache 里永远躺着一个 PMD 大小的 folio 。cache 空了、或者已经退化成单页状态时,消费者要么直接看单个槽位(mincore),要么把 PMD swap entry 拆开、走 PTE 路径重试。MADV_FREE 更干脆——整个 PMD 原地释放,只在建议范围只覆盖部分 PMD 时才拆。zswap 的原生 PMD 序读写刻意留作后续(Alexandre Ghiti 在做),本期 zswap 仍按 order-0 存,遇到带 zswap entry 的范围就拆分走 PTE;swap_map 记账保持按槽位不变。
效益 匿名 THP 的 swap 往返第一次能保住大页形状:省掉一整个 PTE 页表页、省掉 khugepaged 的事后折叠,换回后立刻又是大页。17 个 pmd_swap selftest 在 x86_64 上 zswap 开与关都通过。
下一步 原生 PMD 序 zswap 的 load/store 是明确的下一步。系列里还有个值得一看的注记:因为生产者排在最后,前 27 帖的消费者代码在被引入的那一刻是「不可达」的,自动化审查(sashiko)反复把它们报成坏的,作者专门写了一段解释。
一句话点评 大页换出被拆碎是 THP 落地以来的一笔老账,这一版把「拆」从必经之路降级成了退路——真正难的不是编码,而是让 20 多个消费者先全部就位才敢开生产者。
🔗 原文
📰 net / column ★ 7.1 加的一道校验,把 IFLA_INET_CONF 的旧用户态读法打挂了〔09-15 03:02 北京〕· [PATCH v2] net: allow IFLA_INET_CONF messages when NLA_F_NESTED unset(8 帖讨论)
定位 netlink 属性解析层。7.1 的提交 fa8fca88714c(ipv4: validate IPV4_DEVCONF attributes properly)把 inet_validate_link_af() 里的 nla_for_each_nested() 换成了 nla_parse_nested(),副作用是开始强制要求 IFLA_INET_CONF 带上 NLA_F_NESTED 标志——以前根本不查。
做法 结果是 7.1 之前一直能跑(虽然没设 NLA_F_NESTED)的用户态代码现在会被直接拒绝。作者主张退回 nla_parse() 恢复兼容;Ido Schimmel 则明确反对用 nla_parse_nested_deprecated(),因为它会放行超出最大 type 或 type 为 0 的属性,到 inet_set_link_af() 里可能直接崩,建议改用 nla_parse_deprecated_strict()。
效益 修法本身只有 4 行,但走哪条路决定了「兼容旧用户态」和「保住刚加上的校验」能不能同时成立。这是纯用户可见回归,值得盯最终落地的版本。
和你相关 如果你维护任何用 netlink 配 IP 地址的工具(keepalived、网络管理脚本),这就是 7.1 之后忽然报错的元凶。
🔗 原文
📰 mm / column ★ VM_SPECIAL 退场:VMA flag 从「一堆位」改成「说行为」的谓词〔09-14 22:59 北京〕· [PATCH v2 00/40] mm: make VMA flag semantics explicit, eliminate VM_SPECIAL
定位 VMA(虚拟内存区域)标志位这一层。VM_SPECIAL / VMA_SPECIAL_FLAGS 这个掩码把好几件互不相干的事搅在一起:这块映射是不是内核自己的(MMIO、内核分配页、驱动自己映射的页)、能不能扩展或合并、是不是 mlock 这种迁移可能竞态的怪例、是不是只想让 GUP 别碰它。驱动作者常年被它绕晕,hugetlb 又设了 VMA_DONTEXPAND_BIT 却不想被当成 special,VMA_IO_BIT 更是既被驱动滥用又被 mlock 滥用。
做法 40 帖做两件事:一是限制驱动能拿 VMA flag 干什么,确立「只有内核自有的映射才能设 VMA_IO_BIT / 清除 VMA_MAYWRITE_BIT」这个不变量,并在每次 mmap 与 mmap_prepare 钩子返回后校验 VMA 状态;顺带把 usbmon、sg 迁到 mmap_prepare,新增一个「映射不连续内核页」的 mmap action,让 hfi1 和 ALSA PCM status page 改成主动映射。二是把 VM_SPECIAL 和一堆裸 flag 判断全部换成描述行为的谓词——vma_is_kernel_owned()、vma_can_merge()、vma_is_persistent() 之类。
效益 驱动作者不用再猜「special 到底 special 在哪」,mm 内部也终于能对 flag 的用法做合理假设。另外 uprobes、bpf arena、fbdev defio、HSI cmt_speech 这几处「映射内核内存却没设 VMA_MIXEDMAP_BIT」的历史欠账一并补上。
和你相关 写驱动的同学留意:这 40 帖在给 mmap 钩子立规矩,以后在钩子里乱动 VMA flag 会被内核主动挡下来。
🔗 原文
★ collapse 57 帖 RFC 迎来实质评审:并发正确性与 rmap 锁序是焦点〔09-14 23:07 北京〕· Re: [RFC PATCH 00/57] mm/collapse: rebuild collapse on migration primitives
定位 我们 8 月 17 日跟过的那个 RFC:把 khugepaged 的匿名 collapse 整个重建在迁移原语之上,用 migration entry 冻结源页、支持亚 PMD 范围的折叠。当时只有系列本身,今天 David Hildenbrand 给出了逐点的实质评审。
做法 他挑出两块硬骨头。一是并发:MADV_DONTNEED 可以在折叠过程中清掉 migration PTE、甚至重新缺页出新的匿名 folio。作者回应说在 install 阶段会重新采样 PTE、发现变化就放弃该候选窗口并回滚。二是 rmap 锁序:一个 PMD 跨了不相干的多个 VMA 时,需要同时锁住多个 anon_vma;而 mm/rmap.c 里只有单一 anon_vma->rwsem 层级,没有现成的排序规则,作者也承认 try-lock 大概是唯一出路。评审还指出「PMD 粒度操作只在单个 VMA 独占 PMD 时才安全」这句话说过头了——只要所有页表遍历者都能停下来就安全。
效益 讨论把「khugepaged 现在也不算安静,重建之后到底安静多少、谁在乎」这个真问题摆上了台面。另外 Lorenzo 正在做的 scalable COW 简化,据评审说会顺带解开 anon_vma 那个锁序死结。
和你相关 想做 mm 方向贡献的同学,这条线程是难得的教材:一个 57 帖的大系列,评审关注点全压在并发与锁序上,而不是功能本身。
🔗 原文
📰 media 视频采集 / column ★ ipu6 为「一个源多条流」铺的 21 帖:流控制搬进 CSI-2 接收器〔09-15 04:54 北京〕· [PATCH 00/21] IPU6 multi-stream and metadata support preparation
定位 Intel IPU6 摄像头驱动的流管理层。现在它按「一个 sub-device 一路流」来组织,而 metadata 系列要求一个源能同时吐多条流(比如图像 + 元数据各走一路)。
做法 Sakari Ailus 把流控制从 IPU6 主驱动搬进 CSI-2 接收器驱动:IPU 的各条流收进 CSI-2 接收器的 sub-device 上下文,接收器源 pad 的流号恒为 0,全部流都起来才真正开流、有一条停就停;同时给 CSI-2 流的 enable/disable 加上 lockdep 检查、重做 watermark 的计算与设置、把固件初始化搬进 runtime PM 回调、去掉自己维护的电源状态。
效益 这 21 帖是从更大的 metadata 系列里切出来的一部分,作者判断它可以先合——先把 ipu6 改造成「多流就绪」,等 metadata 主体合入时就不用再大改一遍。
和你相关 做摄像头/CSI-2 的同学值得看第 16 帖:它在 V4L2 的流模型与 IPU6 固件的流模型之间架桥,正是多流方案最容易翻车的地方。
🔗 原文
★ camss 第一次支持 CSI-2 桥后面挂多颗摄像头〔09-14 21:34 北京〕· [PATCH 0/8] media: qcom: camss: support several cameras behind a CSI-2 bridge
定位 Qualcomm CAMSS 的管线拓扑层。此前 CAMSS 见过的都是「一颗 sensor 直连一个 CSIPHY」,而 GMSL 这类 CSI-2 到 CSI-2 的桥(解串器夹在 sensor 和 SoC 中间)把这个假设全打破了。
做法 同时覆盖两种桥拓扑:一种是两颗摄像头汇聚到同一个 CSI-2 端口、以两个虚拟通道进入、由 CSID 解复用送到同一个 VFE 的 RDI0/RDI1(此时 CSIPHY 与 CSID 被两条管线共享,VFE 17x 有两个写主端同时活动);另一种是两颗摄像头分别走解串器的两个 CSI-2 端口、接到两个 CSIPHY,同一个 sub-device 要为两个 endpoint 各绑一次、各领一条独立管线。第 1 帖还纠正了「sensor 就是 CSI-2 发送端」的假设——接收端该配什么速率,得问真正驱动总线的那一方,v4l2_get_link_freq() 本来就会问。
效益 第 3、4、5 帖本身是独立的 bug 修复——任何「一个 VFE 同时跑两条 RDI」的配置都会踩到,不只桥场景。已在 RB3 Gen2 上用 MAX96717 串行器 + AR0234/IMX900 实测:两颗摄像头并发取流、以及一颗反复启停而另一颗持续取流,互不干扰。
和你相关 这就是多摄 / GMSL 链路的正面战场:桥的引入让 CSIPHY、CSID、VFE 的共享与引用计数全部要重算,做车载或工业多摄的可以直接对照自己踩的坑。
🔗 原文
📰 DRM / column ★ 联发科一次补齐 DSC 压缩、WDMA 写回与 MT8189/96 的 DSI〔09-14 19:58 北京〕· [PATCH v7 00/13] drm/mediatek: Add DSC, WDMA, MT8189/96 DSI support
定位 mediatek DRM 驱动的显示输出层。缺的是三块:DSC(显示流压缩,在带宽不够时把像素流压着传)、WDMA(Write DMA,把显示内容写回内存的写回引擎)、以及 MT8189/MT8196 两代新 SoC 的 DSI 支持。
做法 13 帖把 mtk_dsi 的寄存器偏移改成按 SoC 的常量表、把最大链路速率挪进 platform data、加中断时序与 PM Runtime 处理,再补上 MT8189 与 MT8196 的 compatible;DSC 与 WDMA 各自成模块,WDMA 补了更多 SoC 的设备树 compatible。
效益 新 SoC 的高分辨率输出与写回路径一次到位;对老平台,链路速率参数化之后不用再改代码就能描述新 PHY。
和你相关 写 DRM 驱动的同学可以看它怎么把「每代 SoC 一点点差异」收敛成 platform data + 常量表,这是避免驱动被 #ifdef 淹没的标准做法。
🔗 原文
📰 PCI / column ★ P2PDMA 不再给所有 TLP 一个答案:按类别决定点对点路由〔09-14 19:22 北京〕· [PATCH v6 00/18] PCI/P2PDMA: Route peer-to-peer DMA by TLP class
定位 PCI 点对点 DMA 的 ACS(访问控制服务)判定层。现有代码把 Request 与 Completion Redirect 一路套到底,结果是:非对称交换机与嵌套交换机被误判,而所有类型的 TLP(事务层包)又只得到一个统一答案。
做法 三条 ACS 控制实际上作用在客户端选定的 TLP 属性上,而不是拓扑上——Translation Blocking 与 Direct Translated P2P 看的是 Request 的地址类型,Completion Redirect 则跳过带 Relaxed Ordering 的 Completion。v6 改成在路径的分叉点上按方向分别评估,一次遍历决定每个 TLP 类别,并把结果通过回调暴露给 dma-buf 导入方,mlx5 也从「自己假设」改成「直接问」。
效益 点对点 DMA 对 GPU/NVMe/RDMA 之间的直连路径影响直接,这一版把「哪条路真的能走」从拍脑袋变成可查询;v6 还把 dma-buf 侧从直接存指针改成回调。
和你相关 如果你的场景是 GPU 直读 NVMe、或 RDMA 网卡与显存直连,这条决定了内核是放行还是退回主机桥绕行。
🔗 原文
📰 Rust / column ★ 一个用 LLM 找 bug 的工具,在 safe trait 里挖出了不健全〔09-15 05:47 北京〕· [PATCH 0/1] rust: block: Fix unsoundness in Operations::queue_rq
定位 Rust for Linux 的块设备抽象层。Operations 是驱动作者实现的 safe trait,而这次的问题恰恰出在「safe trait 却能被安全地写出内存不安全」这个缝里。
做法 报告来自一个叫 FerroLens 的工具:内部用 LLM 扫 Rust 代码找可疑的不健全行为,再由人工复核确认。具体漏洞是——queue_rq 的实现可以克隆一份 ARef 留着,然后返回错误。按 blk-mq 的所有权语义这不合法:返回错误等于把 Request 还给块层,块层可能重排队或结束它,而 ARef 的引用计数本该掉到 0。
效益 保留克隆会让引用计数停在 2 以上,但计数本身并不能阻止底层那次 C 侧分配被释放——于是就是 use-after-free。当前文档和类型签名都没写这条限制,补丁把它补上。有意思的是方法本身:LLM 工具做初筛、人工做确认,这条流水线第一次在 Rust for Linux 上产出了可用的安全报告。
和你相关 给内核写 Rust 的同学注意:safe trait 不等于实现者不会写出 UB,实现处的约束也是 API 契约的一部分。
🔗 原文
📰 block / column ★ iocost 的成本模型终于可插拔,顺手给出 112 倍定价偏差的证据〔09-14 15:34 北京〕· [RFC PATCH v3 0/5] blk-iocost: BPF struct_ops cost model
定位 blk-iocost 的 IO 成本定价层。2019 年 iocost 合入时提交信息就承诺「以后会让 BPF 程序提供成本模型」,代码里也一直留着 calc_vtime_cost() 这个分发点——七年过去,内置的线性模型仍是唯一实现。
做法 v3 照搬 TCP 拥塞控制的注册模式把插槽填上:内置算法仍是默认,新模型可以用 BPF struct_ops 原型验证。配套给出成本模型可被观测的 tracepoint(iocost_ioc_tick)、测试与文档。
效益 系列最有价值的部分是它量化了内置模型的三类误判:在 virtio-blk + HDD autop 配置下,一次 4K IO 被判为顺序时约 24us、判为随机时约 2.7ms,相差 112 倍——判错就等于定错价。同一个 cgroup 里两个合法的顺序读(多表空间的数据库、多线程备份)会让那个全局游标来回打架、被全部按随机计价,实测多收 89 倍;反过来,落在 16MB 阈值以内的热点随机 IO 被当成顺序,实测少收 107 倍。结论是:要区分多条流,需要的是逐 IO 的状态跟踪,也就是逻辑,而不是再调这六个内置参数。
和你相关 凡是被 IO 限速莫名压制、或反过来觉得限速没生效的场景,这份测量数据都值得对照一下自己的负载形状。
🔗 原文
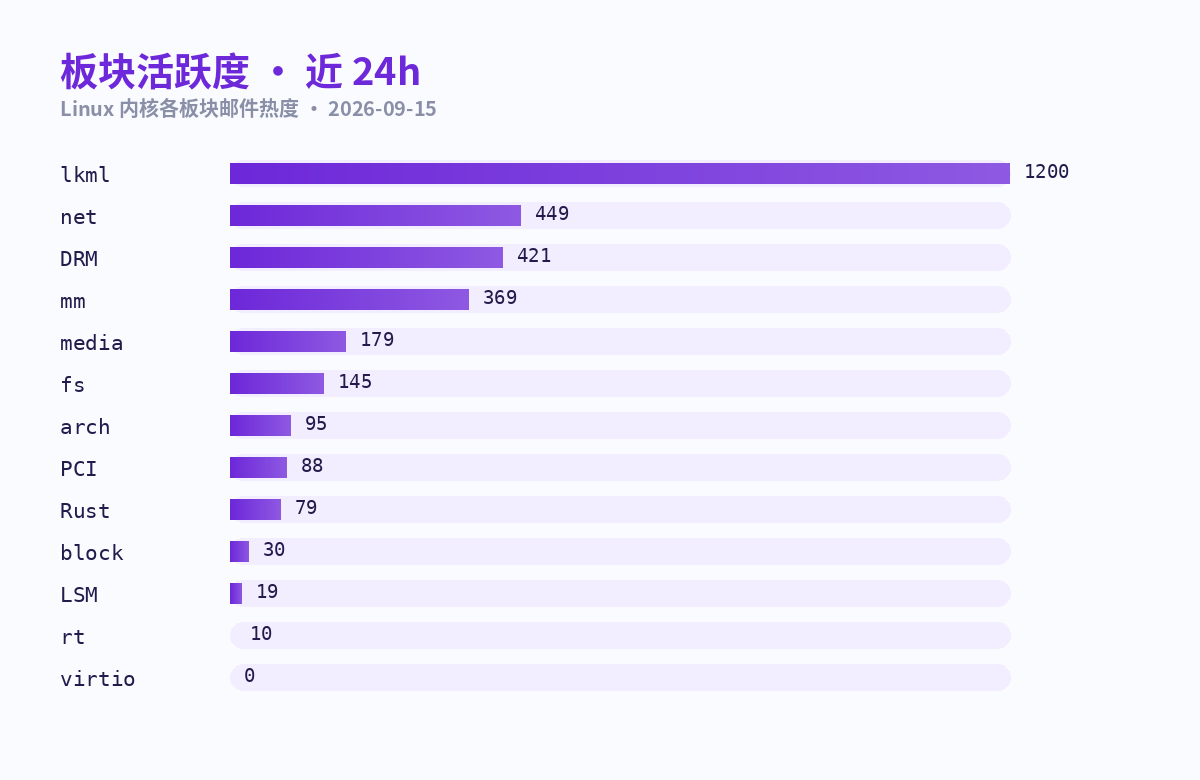
📊 板块活跃度 / column 近 24h 各板块真实统计:lkml 1200(限流上限)· net 449 · DRM 421 · mm 369 · media 179 · fs 145 · arch 95 · PCI 88 · Rust 79 · block 30 · LSM 19 · rt 10 · virtio 0。net 与 mm 今天既量大有质——两个头条都出自这里;virtio 为 0 是因为 virtio-dev 按最近 20 条抓取,窗口内没有新帖(virtio-blk inline encryption 的最新版落在 linux-block 与 virtio-dev 的 09-13 时段)。
📌 机制雷达:5 条跨域大改动 / section PMD swap entry 页表编码层为「512 个连续 swap 槽」新增一个紧凑表示,匿名 THP 的换入换出第一次能保住大页形状(v7·29 帖)· 原文 VMA 谓词体系 VM_SPECIAL 掩码拆掉,换成 vma_is_kernel_owned() / vma_can_merge() 这类描述行为的谓词,并给 mmap 钩子立下「只有内核自有映射才能动 flag」的不变量(v2·40 帖)
IPPROTO_QUIC 内核新增一个 socket 家族,握手经 net/handshake 交给用户态,传输与控制全在内核,按 ALPN 向用户态进程分发连接(v15·15 帖)
按 TLP 类别路由 P2PDMA 放弃「所有 TLP 一个答案」,在路径分叉点按方向与 TLP 属性分别判定 ACS 路由,并把结果开放给 dma-buf 导入方(v6·18 帖)
iocost 成本模型插槽 填上 2019 年就留好的 calc_vtime_cost() 分发点,让成本模型可以用 BPF struct_ops 原型验证,附带 89~112 倍误定价的实测证据(RFC v3·5 帖)
📖 本期概念速查 / section QUIC / IPPROTO_QUIC 跑在 UDP 之上的加密多路复用传输(RFC 9000),HTTP/3 的底座;IPPROTO_QUIC 是内核里新建的 socket 协议类型,用法类似 IPPROTO_MPTCP。
net/handshake 内核向用户态请求「帮我完成一次握手」的 netlink 接口;QUIC 用它把 TLS 握手外包给 tlshd 这类用户态服务。
ALPN TLS 握手时协商应用层协议名的字段;这里被内核用来把同一个 QUIC 端口上的连接分发给不同的用户态进程。
PMD swap entry 一条页表项代表 HPAGE_PMD_NR 个连续 swap 槽位,代替原来的 512 条 PTE 级 swap entry;换来的是不必为它们单独分配一个页表页。
khugepaged 内核里负责把零散 4K 页折叠回大页的后台线程;PMD swap entry 的目标之一就是让换回的大页不必再等它。
TLP / ACS TLP 是 PCIe 上的事务层包;ACS 是 PCIe 交换机的访问控制服务,决定点对点流量能不能直穿交换机而不绕回主机桥。
DSC / WDMA DSC 是显示流压缩,带宽不够时压缩像素流传输;WDMA 是写回引擎,把显示内容写回内存供截图、录制或合成使用。
safe trait(Rust) Rust 里可以由安全代码实现的 trait。safe 只保证实现者不必写 unsafe,并不保证实现者写不出内存不安全——API 契约仍要靠文档与设计来兜。
如果对你有用,点个赞,或留言聊聊你最关心的。
数据来源:lore.kernel.org(全内核 13 列表)· 数据截至 09-15 06:50 北京 · 北京时间
💬 评论
使用 GitHub 账号登录即可留言