今天 Linux 内核圈,值得花 3 分钟看三件事:机密内存『就地换手』——KVM 的 guest_memfd 支持共享↔私有就地转换,45 帖大系列,转换不再拷贝整页数据;老牌 PG_private 页标志谢幕——mm 用『看指针』替代『看标志位』,把它从 page flags 里删掉;以及 7.3 开发窗口开启——net-next OPEN,sched_ext / cgroup / workqueue 的 Fixes for v7.3-rc1 陆续到位。
🎬 今日导读
/ section 头条 guest_memfd 就地转换——机密内存换手不再拷贝整页,KVM/mm 45 帖(v12)
头条 PG_private 移除——mm 用 folio->private 指针替代页标志位(v2,14 帖)
net net-next OPEN,7.3 开发窗口开启;线程级 pidfd 收发、r8169 RSS 补全
DRM 53 帖删掉 reset():全驱动转 atomic_create_state;骁龙 DP 补 MST
LSM Landlock 规则集可直接用 BPF 程序声明(v2,15 帖)
mm 设备 DAX 吃上 HVO vmemmap 优化;xswap 提出可扩展交换设备
💡 今日头条
/ section 机密内存『就地换手』:guest_memfd 转换页不再拷数据,直接改属性
〔08-31 08:25 北京〕· [PATCH v12 00/45] guest_memfd: In-place conversion support
现状 guest_memfd 是机密计算(TDX / SNP)下管理客户机内存的机制:每页分『私有』(private,加密、宿主(host)不可读)与『共享』(shared,可映射给设备做 DMA)。客户机做 I/O 时,页要在两种状态之间来回转换。
痛点 现有转换是『复制式』的:要把页内容拷到新页、撤销旧映射、重新分配页,再为新状态建映射。一次转换就是一次整页拷贝 + 页表与 TLB 抖动;NVMe / virtio 这类队列页频繁换手的场景,开销被放大。
方案 v12 系列 45 帖落地『就地转换』(in-place conversion):同一物理页直接改属性。核心件包括 per-gmem 内存属性、新的 KVM_SET_MEMORY_ATTRIBUTES2、转换时把 shared 与 private 两侧映射都失效、架构回调 make_shared / make_private,以及 SEV / TDX 侧的适配(SNP_LAUNCH_UPDATE 的 uaddr、TDX_INIT_MEM_REGION 的 source page 变为可选)。
为什么 就地转换的前提是『页在转换时没有被占用』,所以系列里配了严格的页引用计数检查(refcount + LRU fbatch 处理);确认安全后,省掉拷贝比复制式在时延与内存带宽上都划算。v12 的架构回调已覆盖 x86,selftests 补齐了单页、INIT_SHARED、跨进程一致性等用例。
效益 转换从『拷数据 + 换页』变成『改属性 + 刷 TLB』;机密 VM 里高频 DMA 页面的换手延迟显著下降,也省了临时页的分配与归还。
下一步 v12 已相当完整,等待 7.3 评审窗口;除 x86 外的其他架构回调是自然跟进点,有兴趣可以盯系列里标注 TODO 的部分。
一句话点评 机密计算里最『肉疼』的共享↔私有转换被砍掉拷贝成本——这是 CoCo VM 性能落地的一块关键拼图
🔗 原文
看标志位改成看指针:25 岁的 PG_private 页标志从内核谢幕
〔09-01 03:26 北京〕· [PATCH v2 00/14] Remove PG_private by using page/folio->private checks instead
现状 每个物理页(page / folio)有一组标志位(page flags)。PG_private 是其中一员,历史上表达『这个页的 private 指针字段存了私有数据』——文件系统、zsmalloc、perf 环形缓冲等都会用到它。
痛点 页标志位是稀缺资源(一个 unsigned long 里的位,很多已占满),且标志位的读写是原子位操作;而 folio 化之后,『private 指针有没有值』本来就能直接判断。于是『先看位、再取指针』变成一道多余的间接层。
方案 14 帖把『看标志位』改成『看指针』:zsmalloc 改指针比较、perf 环形缓冲不再把 PG_private 当高阶页标记、xen grant-table / fscrypt 弹跳页 / f2fs / erofs 陆续停用;引入 folio_test_fs_private()、readahead_folio_last() 等新 helper,最后 treewide 替换 PagePrivate() → page_private() 并删除该标志位。
为什么 folio 转型已经把页打包成大页抽象后,页标志位的语义与 folio->private 指针重叠;继续保留位只是历史包袱。删掉它既释放标志位空间(给未来新标志腾位),也让读路径少一次位测试。
效益 page flags 少占用一位,未来加新标志的余量变大;private 判断路径更直接;树内所有 PG_private 用户一次性收敛,代码更干净。
下一步 v2 正在 mm 列表评审(NVIDIA 开发者提交);剩下的潜在用户清理完毕后,该标志位及相关接口即从内核彻底移除。
一句话点评 『能直接看指针,就别占一位标志』——folio 时代给老页标志收尾的典型动作
🔗 原文
📰 mm
/ column ★ 设备 DAX 吃上 HVO:稀疏 vmemmap 的共享尾页推广到持久内存
〔08-31 15:54 北京〕· [PATCH 00/11] mm: Switch device DAX to section-based vmemmap optimization
定位 大内存设备(持久内存 / DAX)的每个物理页都要一份 struct page,vmemmap 的『内存税』随容量线性放大;HVO(HugeTLB vmemmap 优化)此前只给 THP / HugeTLB 用。
做法 11 帖把 section 级 vmemmap 优化推广到 device DAX:新增 CONFIG_SPARSEMEM_VMEMMAP_OPTIMIZATION,共享复合页(compound page)的尾页 struct page,powerpc 同步接入,文档同步更新。
效益或下一步 TB 级持久内存的 struct page 占用显著下降;作者正是当年 HVO 的开发者(songmuchun)。
和你相关 做大内存、持久内存或 NFV 场景的,这套『省 struct page』的思路可以直接借鉴。
🔗 原文
★ xswap:让交换设备『可扩展』,由 zswap 背书
〔09-01 01:54 北京〕· Re: [PATCH 00/16] xswap: extendable swap device backed by zswap
定位 swap 子系统把交换空间做成固定结构(slot + 页表),想接入新后端(如由 zswap 支撑的虚拟交换设备)就要动核心抽象。
做法 00/16 提出 xswap——一个可扩展的交换设备抽象,存储后端由 zswap 担任;syzbot 已经开始盯它的并发与边界路径。
效益或下一步 为内存压缩 / 去重类交换后端铺路;仍处早期讨论,适合想跟进的读者在列表里考古。
和你相关 关注 zswap / 内存压缩方向的话,这是一个值得放进雷达的长期线。
🔗 原文
📰 DRM
/ column ★ 删掉 reset():DRM 用 53 帖把全驱动转成 atomic_create_state
〔09-01 00:17 北京〕· [PATCH v3 00/40] drm/plane: Convert all drivers to atomic_create_state and remove reset
定位 DRM 的状态机历史上保留两套创建路径——老式 reset() 回调与新的 atomic_create_state(),每个驱动都要各自实现,接口收敛度差。
做法 两个系列共 53 帖:40 帖把 plane、13 帖把 crtc 的所有驱动迁到 atomic_create_state,随后删除 reset() 接口。这是一次贯穿全部 GPU / 显示驱动的核心 API 清理。
效益或下一步 核心接口归一,驱动状态初始化统一走 atomic 路径、样板代码减少;对维护者是『教科书级』的跨驱动重构。
和你相关 写 DRM 驱动或内核图形栈的同学,这套 API 收口值得追——接口变了,驱动迟早要跟上。
🔗 原文
★ 骁龙 DP 补 MST:一条 DP 口带多路显示器(v6,29 帖)
〔08-31 16:17 北京〕· [PATCH v6 00/29] drm/msm/dp: Add MST support for MSM chipsets
定位 高通 MSM 的 DisplayPort 控制器此前只支持单流(SST),多显示器要么靠多个物理口、要么靠 Type-C 扩展坞降级。
做法 29 帖为 msm/dp 引入 MST(多流传输):stream_id、VCPF/ACT 包、通道 slot 分配、新的 dp_mst_drm 模块、dpu 的 per-stream encoder。
效益或下一步 一个 DP 口级联多屏,骁龙笔记本 / 平板的扩展能力提升;v6 评审中,离合入又近一步。
和你相关 用高通平台做设备、或关注内核 DP 栈的,这条大系列值得跟踪。
🔗 原文
📰 net
/ column ★ 收发也带『线程身份』:pidfd 精确到线程(SO_PASSPIDFD_THREAD)
〔08-31 19:21 北京〕· [PATCH 00/10] net: support thread-specific pidfds for send and connect
定位 SCM_PIDFD / peer pidfd 只能拿到『进程级』pidfd,多线程服务(如每个连接一个线程)想精确到具体线程身份做不到。
做法 10 帖把 sk_peer_pid 改成按 pid 类型索引的数组,af_unix 记录发送 / 连接线程的 pid,新增 SO_PASSPIDFD_THREAD 与 SO_PEERPIDFD_THREAD;pidfs 顺带记录 coredump 线程。
效益或下一步 权限审计与追踪能精确到线程,unix socket 的对端身份不再『止步于进程』;跨 net 与 pidfs 的机制级改动。
和你相关 做服务端框架、容器或安全审计的,线程级身份是个实用的小能力。
🔗 原文
★ r8169 补 RSS:RTL8127 多队列调度 + 驱动 phylink 化(v12 / v9)
〔08-31 13:40 北京〕· [PATCH net-next v12 0/7] r8169: add RSS support for RTL8127
定位 Realtek 经典 r8169 驱动长期单队列,RTL8127 等新芯片的多队列硬件能力一直没用上。
做法 v12 的 7 帖加 RSS 支持(多中断、多队列 RX 路径重构、ethtool get_channel);v9 的 7 帖把驱动转 phylink,新增 RTL8116af / RTL8127atf 支持并修 LTR / s0idle。
效益或下一步 主流板载千兆 / 2.5G 网卡的吞吐与多核扩展性提升——DIY 装机用户最能感知的一类改动。
和你相关 家里 / 服务器板载 Realtek 网卡的,升级内核就能吃到这几帖的收益。
🔗 原文
★ virtio_net ethtool 流规则(v23):虚拟机里也能给网卡配分流
〔09-01 00:11 北京〕· [PATCH net-next v23 00/14] virtio_net: Add ethtool flow rules support
定位 virtio_net 一直缺 ethtool 流分类(flow steering),虚拟机网卡想做队列分流只能靠客户机内软处理。
做法 14 帖经 virtio admin command 提供 flow filter:ethtool 侧新增 ethtool_flow_type_mask(),实现 L2 / IPv4 / IPv6 / TCP / UDP 流规则查询与下发。
效益或下一步 虚拟网卡获得硬件流表能力,云里跑 DPDK / 高吞吐业务的客户机受益;已到第 23 版,非常成熟。
和你相关 做虚拟化、云网络或 virtio 方向的,这条长系列是 ethtool ↔ virtio 对接的参考实现。
🔗 原文
📰 security
/ column ★ Landlock 规则集可以直接用 BPF 程序声明(v2,15 帖)
〔08-31 22:59 北京〕· [PATCH v2 00/15] BPF interface for applying Landlock rulesets
定位 Landlock 是无特权沙箱(LSM),规则集目前用 C 结构体在用户态拼好再加载,表达能力与可组合性有限。
做法 15 帖引入 BPF 接口:用 BPF 程序声明 Landlock 规则集(新增 landlock 程序类型与 kfunc),规则变得可编程、可动态组合、可按需加载。
效益或下一步 沙箱策略可以像 BPF 程序一样分发与迭代,容器运行时、安全研究者重点关注。
和你相关 做沙箱、容器隔离或安全策略引擎的,这是『规则即代码』的一个现实落点。
🔗 原文
★ BPF LSM 挂到新地方:netlink 收包与 ethtool 控制面也能插 hook(0/7)
〔08-31 18:59 北京〕· [PATCH bpf-next 0/7] Add new way to add BPF LSM hooks
定位 BPF LSM 此前只覆盖少量安全 hook;网络管理面(netlink 消息、ethtool)缺少 LSM 可见性,很难用 BPF 做网络策略。
做法 7 帖放开 BPF LSM 可挂载的 hook 集,新增 netlink msg_rcv 与 ethtool 控制路径的通用 hook,并补 netdevsim 测试库。
效益或下一步 用 BPF 对网络管理面做行为监控 / 策略控制成为可能,把『观测 + 拦截』合到一套 BPF 程序里。
和你相关 想把 BPF 用到网络策略 / 平台安全上,这条 hook 扩展是基础能力。
🔗 原文
📰 block
/ column ★ 离线 / 只读 zone 统一视为『死区』(v6,12 帖)
〔08-31 11:41 北京〕· [PATCH v6 00/12] Improve handling of offline and read-only zones
定位 分区(zoned)块设备里 offline / read-only zone 的处理散落多处,与 zone 写插头(write plug)的管理不一致,revalidate 时可能残留状态。
做法 12 帖统一:容量变化时 drop 全部写插头、offline / read-only zone 一律按 dead 处理、对这些 zone 的读写管理操作直接失败、允许只读 / 离线 conventional zone 存在。
效益或下一步 ZNS SSD / SMR 盘的可靠性路径更一致,退化状态下不再有『半活』语义;v6 已很接近合入。
和你相关 做存储 / 文件系统、或管理 ZNS / SMR 设备的,这套语义统一值得读。
🔗 原文
★ 校验和读的 lazy bounce:把完整性校验挪进文件系统(V2,17 帖)
〔08-31 14:40 北京〕· lazy bounce buffering for checksummed reads V2
定位 带 T10 PI / DIF 校验和(integrity)的直接 I/O 读,块层现在用 bounce buffer 把校验和『先拷贝对齐再验』,即使校验本身不需要。
做法 hch 的 17 帖把完整性校验下沉到文件系统:iomap 加 IOMAP_IOEND_INTEGRITY 标志、xfs 在 ->submit_io 里处理 PI、按需才走 lazy bounce 缓冲。
效益或下一步 消除不必要的提前拷贝、按需才 bounce;block / iomap / xfs 三层协调,是跨层改动的范本。
和你相关 做存储栈或 xfs 的,这套『谁真正需要校验谁处理』的职责下沉是值得对照的设计。
🔗 原文
📰 sched
/ column ★ 把 cgroup 更新锁提升到核心层:别让 CFS/SCX 各调各的
〔09-01 06:36 北京〕· [PATCH v3] sched: Lift cgroup update locking to core to prevent CFS/SCX divergence
定位 调度器的 cgroup 带宽 / 亲和更新,CFS 与 sched_ext 各自实现,锁语义不一致会渐渐『发散』。
做法 把 cgroup 更新锁提到核心调度层,CFS / SCX 走同一条更新路径;配套 sched_ext 的 Fixes for v7.3-rc1 也在 7.3 修复窗口陆续落地。
效益或下一步 两种调度器行为一致、sched_ext 调度器更稳;7.3 修复窗口(rc1 前)正是这类收紧的好时机。
和你相关 玩 sched_ext 或做调度优化的,这套『核心统一、避免各写各的』是长期正确的方向。
🔗 原文
📊 板块活跃度 · 近 24h
/ column 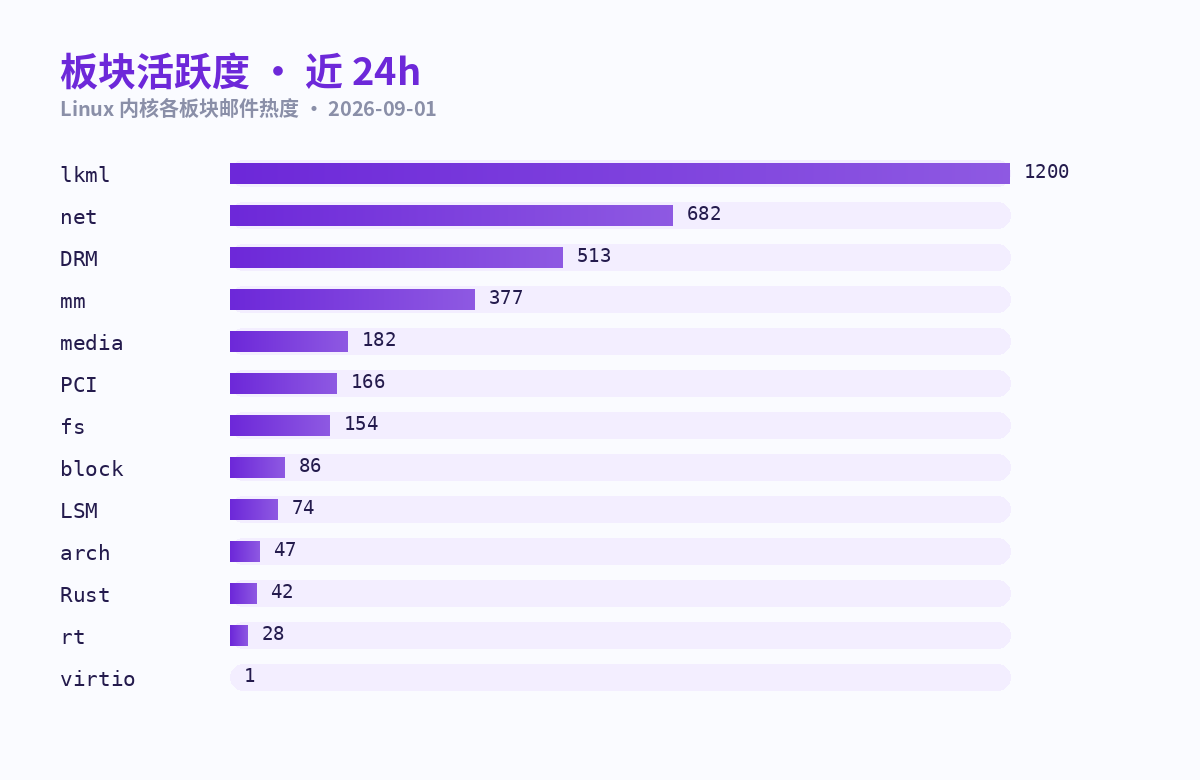
Top3 lkml 1200 · net 682 · DRM 513(radar.sh stats 全 13 列表 T24 计数)
观察 net 继续最活跃(682),mm(377)次之;virtio-dev 低频窗口内仅 1 条,virtio 板块信号主要靠跨帖捕获(本日 FBE 内联加密讨论即来自 block 侧)。
⚙️ 机制雷达:4 条跨域大改动
/ section core barrier: 新增 smp_cond_load_{relaxed,acquire}_timeout() 通用超时原语(v15,16 帖)——锁 / RCU / 调度等待都可用 原文 arch entry: 整合并重做系统调用入口处理(00/18)——x86 syscall entry 收敛,跨架构语义统一 原文 lkml DEPT(DEPendency Tracker)v19——lockdep 式依赖追踪器,检测锁 / 依赖环,v19 已相当成熟 原文 virtio FBE 虚拟化:virtio-blk 客户机内联加密(讨论继续,11 帖)——qcom crypto_virt / ICE keyslot 分区,跨 virtio / crypto / block 原文
📖 本期概念速查
/ section guest_memfd 机密计算的客户机内存文件(fd),管理『私有 / 共享』两类内存页——今日头条主角,转换成本直接决定 CoCo VM 的 I/O 性能。
私有 / 共享内存 TDX / SNP 下 guest 页分『私有』(加密、宿主不可读)与『共享』(可映射给设备 DMA),I/O 时在两者间转换。
PG_private 页标志位,历史含义是『页的 private 指针有值』;本日被 mm 用直接判断指针的方式替代并从 page flags 删除。
vmemmap struct page 数组的虚拟映射;HVO 让大页 / 持久内存共享复合页尾页,显著省内存税。
MST(DisplayPort) 多流传输:一条 DP 主链路按时间片切给多路显示器,Type-C 扩展坞 / 级联显示器的底层技术。
pidfd 进程文件描述符,稳定引用一个进程;本日 net 头条把粒度推进到『线程级』。
Landlock 无特权进程沙箱 LSM;本日两条 signal 都是它——BPF 规则集与 MPTCP 访问权。
如果觉得有用,点个赞,或留言聊聊你最关心的内核话题。
数据来源:lore.kernel.org(全内核 13 列表)· 北京时间
💬 评论
使用 GitHub 账号登录即可留言