今天 Linux 内核圈,值得花 3 分钟看两件事:新机制 folio_pool 登场——一个直达大页的热路径内存池,lockdep、BPF、netfilter、DRM 首批接入;和 Qualcomm 的 DSP 加速器驱动 QDA 推进到 v2,15 帖新框架级驱动。
🎬 今日导读
/ section 头条 folio_pool/scratchpad:内核热路径内存池新机制,nf_tables/BPF/lockdep/gpuvm 首批接入
头条 Qualcomm QDA DSP 加速器驱动 v2(15 帖),FastRPC 纳入 accel 模型
net TLS 1.3 硬件卸载 v16 补 KeyUpdate;net-next 合并窗口关闭
DRM nova-core 新增 NVKV 编解码器;drm_timeout 换算函数统一
mm stackdepot trie 存储 RFC;ceph 写回路径 folio 化;zswap 回写修复
fs vfs 18 个 PULL 齐入 7.3;XFS fs-verity v15
💡 今日头条
/ section新机制 folio_pool:给内核热路径造一个『直达大页的内存池』
现状 内核里大量『短生命周期小对象』——锁校验记录、BPF 校验器栈状态、netfilter 事务描述符、GPU 虚拟地址操作——长期走 SLUB 分配器。对『成批创建、成批销毁』的突发场景,SLUB 每次分配要 freelist 遍历加锁竞争,销毁要 O(N) 逐个 kfree()。而 lockdep 这类核心子系统为防递归死锁,干脆绕开 SLUB,在 .bss 静态预分配 32768 项固定数组(1.31MB)。
痛点 突发批量分配在 SLUB 下开销明显:万级描述符逐个分配与销毁,锁竞争和缓存失效都在。lockdep 的静态数组一旦耗尽,校验就永久关闭——这是个硬上限。
方案 Jim Cromie 的 9 帖系列:直接向 buddy 要一整块 compound 大页(跳过 SLUB 元数据),封装成两种 bump allocator——folio_scratchpad(变长、对齐感知,给事务型批处理用)和 folio_pool(定长槽位,给同构描述符用)。nf_tables、BPF 校验器、drm/gpuvm、BPF syscall 批更新首批接入;lockdep 把静态数组缩成引导期缓冲区,耗尽后回退到 folio_pool 动态扩展。
为什么 bump 分配器是『只推指针、不逐个释放、整页一起还』的模型:分配是直线走指针,批量销毁是 O(1) 的 put_page,天然省掉 SLUB 的锁与链表;整页大内存让同批对象共享暖的 L1/L2 缓存行。
效益 作者给出基准:nf_tables 10,025 个 netlink 事务描述符,分配耗时 -19.4%、异步销毁 -8.6%,合计每批省约 5.6ms(-13.3%)。lockdep 引导期只用 928/4096 项,依赖图可在 late_initcall 迁移压缩进 folio_pool,静态数组 0 字节常驻。
下一步 v1 正挂在 lkml/dri-devel 讨论,Peter Zijlstra 已对 lockdep 部分给出评审。作为新基础设施,谁能把它用进自己的热路径,谁就先享受这份省。
一句话点评 表面是个分配器,实则是给整个内核热路径松绑的机制级改动——值得持续跟进
🔗 原文
Qualcomm DSP 加速器驱动 QDA 推进 v2:FastRPC 纳入标准 accel 模型
现状 GPU 之外还有一类『算力加速器』——DSP(数字信号处理器)。内核用 accel 子系统(drivers/accel,与 DRM 共享基础设施)管理这类设备,给用户态提供计算上下文。Qualcomm 的 DSP 通过 FastRPC 协议通信。
痛点 此前 DSP 加速没有统一的内核驱动:FastRPC 能力散在 misc/char 设备或厂商私有路径,用户态无法用标准 accel 接口(DRM ioctl + GEM 内存模型)管理计算上下文与远端内存映射。
方案 15 帖 v2:新增 accel/qda 驱动,含全新的『compute context bank』总线(并向 iommu_buses 注册 QDA 总线)、GEM_CREATE/MMAP_OFFSET、PRIME DMA-BUF 导入、DSP 进程创建/释放、FastRPC 调用、DSP 地址空间远端映射/解映射,以及独立 QDA UAPI 头。
为什么 选 accel 而不是另开 char 设备:accel 复用 DRM 的 GEM/IOMMU/FD 生命周期框架,用户态计算栈能用同一套模型同时管 GPU 与 DSP。
效益 让高通平台的 DSP 算力(AI/音频/信号处理卸载)对用户态以标准 accel 接口开放,计算框架可统一接入。
下一步 v2 新增了 DSP 远端内存映射,iommu 注册与 UAPI 设计仍在讨论。这类新驱动通常要迭代多轮才能合入,值得盯它的 UAPI 何时稳定。
一句话点评 把 Qualcomm DSP 纳入标准 accel 模型,是算力加速器生态往前推的一步
🔗 原文
📰 media 视频采集
/ column★ ★ Maxim GMSL2/3 加解串器驱动 v15:车规摄像头链路的『串行器』底座继续打磨
定位 链路层:GMSL2/3 是车载摄像头串行传输标准,这组 22 帖驱动把 Maxim 的 serializer(MAX9296A 等)/deserializer(MAX96724 等)做成 v4l2-subdev。
做法 v15 继续细化 max967 解串器与加串框架层接口,评审逐帖推进。
效益 串行器把多路 MIPI 相机信号合并成同轴/差分链路,是车载视觉平台的公共底座。
和你相关 之前追过 GMSL2/3(08-08 日报)——这组驱动进入第 15 轮评审,离合入又近一步。
🔗 原文
★ ★ Microchip ISC 图像信号处理器 10 帖修复:AWB 锁、流停止、端点引用
定位 ISC(Image Sensor Controller)是 Microchip 平台图像传感器接口芯片,含 AWB(自动白平衡)硬件块。
做法 v5 集中修 AWB 工作线程的 mutex 生命周期、stream-stop 时 IRQ/时钟同步、解析端点引用计数,以及 Bayer 模式与 WB 寄存器掩码。
效益 修掉白平衡残留、PM 运行时泄漏、端点引用泄漏等一批隐患。
和你相关 ISP 侧修复对相机驱动开发者有参考价值。
🔗 原文
更多动态
○ dma-buf/dma-heap:fd_install 后 copy_to_user 失败会泄漏 fd,v7 统一改用 dma_buf_fd_install() 修正(含 fastrpc) 〔08-17 13:05〕
○ uvcvideo RFC:用 64 位算术计算 frame buffer 大小,防大分辨率溢出 〔08-17 20:40〕
○ media: usbtv 修断开时的空指针解引用 〔08-17 22:09〕
○ OV5640 传感器驱动 v2:修 sysclk 计算的潜在整数溢出 〔08-18 00:09〕
📰 DRM 显示
/ column★ ★ nova-core 继续长大:新增 NVKV 编解码器 + GSP_INIT schema
定位 nova-core 是 NVIDIA 新 GPU 的 Rust 驱动核心(与 asahi 并行的另一条 Rust 驱动线),落在 dri-devel。
做法 6 帖给 nova-core 加 NVKV(NVIDIA 私有 key-value 编码格式)的 typed 编/解码与 GSP_INIT schema。
效益 为 nova 驱动与 GSP 固件的通信协议打地基,Rust 驱动的编码层往前一步。
和你相关 与 Rust 驱动线相关——nova 之前追过 render 与 guest_memfd。
🔗 原文
★ ★ DRM 等待超时换算函数统一:新增 drm_timeout_rel_to_jiffies()
定位 DRM 核心层的超时换算工具(用户态传 ns 超时、内核按 jiffies 等)。
做法 把 drm_timeout_abs_to_jiffies() 挪进统一 drm_timeout.c,新增相对超时版本,i915/vc4/v3d/amdgpu 改用同一入口。
效益 各驱动不再各自换算,超时语义一处维护、一处修。
和你相关 DRM 驱动开发者日后直接用这套 helper。
🔗 原文
📰 mm 内存管理
/ column★ ★ Cloudflare RFC:把 stackdepot 持久栈迹换成路径压缩 trie 存储
定位 stackdepot(栈迹仓库)是内核把『分配点调用栈』去重存起来的公共设施,kmemleak/page_owner/KASAN/slub 都在用。
做法 Cloudflare 的 9 帖 RFC 引入路径压缩 trie,让持久栈迹共享公共前缀,并给出 boot-time 启用开关。
效益 栈迹存储量级下降,page_owner/kmemleak 这类内存账本能开得更细而不爆内存。
和你相关 mm 基建——影响一切吃栈迹的调试/记账工具。
🔗 原文
★ ★ ceph 写回路径全面 folio 化:10 帖收敛 page 遗留
定位 ceph 文件系统写回路径仍在用 page API,是 folio 迁移的尾巴工程。
做法 v4 把 writepages/写入路径转 folio,修 OSD client 停止时的错误处理,删掉遗留的 page 专用接口。
效益 folio 化后写回路径统一走新抽象,后续维护与性能优化同一条轨道。
和你相关 folio 化是整个内核页面抽象迁移的收尾——ceph 是最后一批大厂 FS。
🔗 原文
★ ★ zswap 回写后 workingset 影子丢了:2 帖修复 refault 误判
定位 swap-in 的 refault(再次缺页)记账决定页面的回收优先级,是 workingset 的核心。
做法 改在 swap-in 而非 swap cache 分配时记 refault,并让 zswap 回写路径保留 workingset shadow。
效益 修 zswap 场景下活跃页被误判为冷、被过早回收的问题。
和你相关 zswap 用户(内存不足的机器)体验直接相关。
🔗 原文
📰 net 网络
/ column★ ★ TLS 1.3 硬件卸载推进 v16:补上 KeyUpdate 收发路径
定位 内核 TLS 设备卸载(kTLS offload)把加解密下沉到网卡,网络协议栈层。
做法 v16 增加 TX/RX KeyUpdate 支持(TLS 1.3 的密钥轮换机制),配套 tracepoint 与硬件卸载自测。
效益 TLS 1.3 密钥更新在硬件卸载场景不再断档,数据中心网卡可完整跑会话重协商。
和你相关 高带宽加密传输(CDN/代理场景)会受益。
🔗 原文
★ ★ Airoha AN8855 五口 DSA 交换机驱动 v20:与 mt7530 共模块化
定位 DSA 是内核托管交换机框架,驱动层新增一个交换机型号。
做法 v20 新增 Airoha AN8855 五口千兆交换机驱动,把 mt7530 的公共函数抽进 lib 模块、MDIO 总线锁并入 regmap。
效益 路由器/AP 常用交换芯片纳入主线,厂商私有网络栈可退役。
和你相关 软路由/OpenWrt 生态会受益。
🔗 原文
★ ★ Motorcomm 四口 2.5GbE PHY 驱动 v11:多网口板卡的新选择
定位 PHY 驱动位于 net 驱动层(物理层媒体芯片,和视频 serdes 同族)。
做法 v11 驱动 Motorcomm 四口 2.5G PHY。
效益 四口 2.5G 适合多网口主板/软路由,PHY 生态继续补齐。
和你相关 板卡硬件选型时可纳入考虑。
🔗 原文
📰 fs 文件系统
/ column★ ★ 7.3 合并窗口开启,vfs 一口气拉 18 个 PULL
定位 合并窗口 = 各子系统维护者把攒了两个多月的功能树汇入 mainline 的窗口。
做法 Brauner 的 vfs 系列 18 个 PULL 全部进 7.3:sync/super/ovl/netfs/mount/iomap/lookup/kfunc…;sched_ext、workqueue、watchdog、NVDIMM/DAX、fscrypt 的 PULL 也同批到达。
效益 VFS 层下一版的功能面一次看清——想跟 7.3 新特性,这两周看 PULL 合并就是清单。
和你相关 合并窗口期间是补丁最容易被接纳的时机,投稿者注意。
🔗 原文
★ ★ XFS fs-verity 支持 v15:post-EOF merkle 树的长期推进
定位 fs-verity 是『文件完整性校验』框架(Android/容器镜像在用),XFS 是最后一块主要拼图。
做法 v15 继续打磨 post-EOF merkle 树的读写路径与 fsync/回收交互,Christoph Hellwig 参与评审。
效益 XFS 用户(服务器/大存储)能给静态文件加防篡改校验。
和你相关 与 fs 完整性、镜像安全分发相关。
🔗 原文
📌 机制雷达:跨域大改动
/ section sched_ext 17 帖系列处理 proxy execution 的远程 DSQ 迁移竞态,讨论密集 · 原文
blkcg io.stat 把 blkcg 每 cgroup 的 IO 统计暴露给 BPF(新 kfunc),运维可编程读取 · 原文
s390 lazy MMU v7 批量 PTE 更新 + 让 KASAN 感知 lazy MMU 模式 · 原文
virtio_ring packed 修 packed ring 一次失败 add 后遗留的过期描述符标志(亚马逊)· 原文
fw_devlink PHY 包 driver core/of 修以太网 PHY 封装器的设备链接,避免探针乱序 · 原文
📊 板块活跃度 · 近 24h
/ column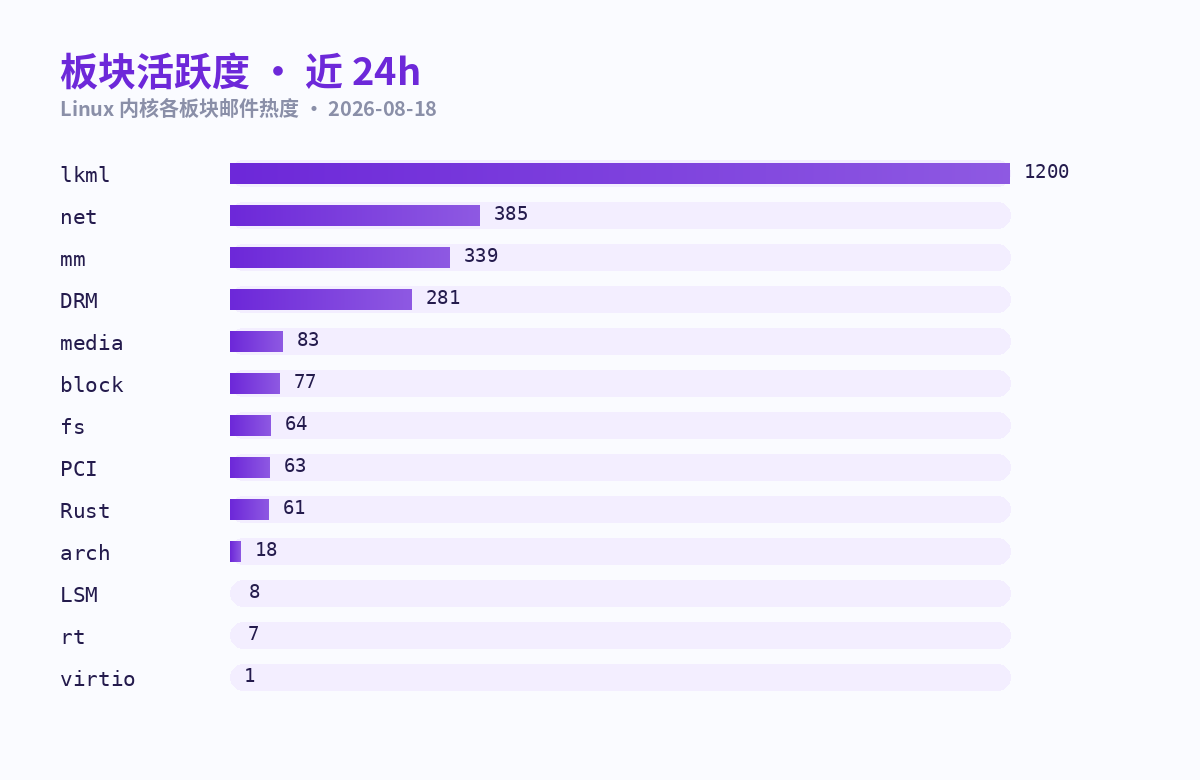
Top3 lkml 1200 · net 385 · mm 339(refresh-heat 06:23 自动刷新)
📖 本期概念速查
/ section bump allocator 只做『推指针分配、整块释放』的分配器,批量场景省掉 SLUB 的锁与链表
合并窗口 merge window rc1 后约两周集中合入各子系统功能树的窗口;net-next 在此期间冻结
DSA Distributed Switch Architecture,内核管理可托管交换机的框架
fs-verity 文件级完整性校验:为文件建 merkle 树,读取时校验,防篡改
accel 子系统 drivers/accel,与 DRM 共享 GEM/IOMMU/FD 框架的算力加速器子系统
GMSL2/3 车载摄像头串行链路标准,分串行器(serializer)与解串器(deserializer)
BPF kfunc 内核向 BPF 程序导出的、可在 BPF 里直接调用的内核函数
NVKV NVIDIA 私有的 key-value 二进制编码格式(GSP 固件通信用)
内核热路径的效率账会持续算下去——点个赞,或留言聊聊你最想追的机制。
数据来源:lore.kernel.org(全内核 13 列表)· 北京时间
💬 评论
使用 GitHub 账号登录即可留言